Cloudflare 将搜索发现与 AI 训练控制分离
Cloudflare 于 2026 年 9 月 15 日宣布进一步细分 AI 流量管理,将搜索、训练和用户指令型代理视为不同的策略维度。新的“禁止 AI 训练”选项,目标是在允许混合用途爬虫继续承担传统搜索索引职责的同时,传达站点内容不得用于模型训练的偏好。
对获授权的网页采集、市场研究、广告验证和代理运营团队而言,这不是绕过限制的新方法,而是要求把任务用途变得可识别、可审计。住宅代理或轮换代理只改变网络出口,不能把训练任务变成搜索任务,也不会自动产生访问权限或覆盖发布者的明确选择。
9 月 15 日具体发生了什么变化
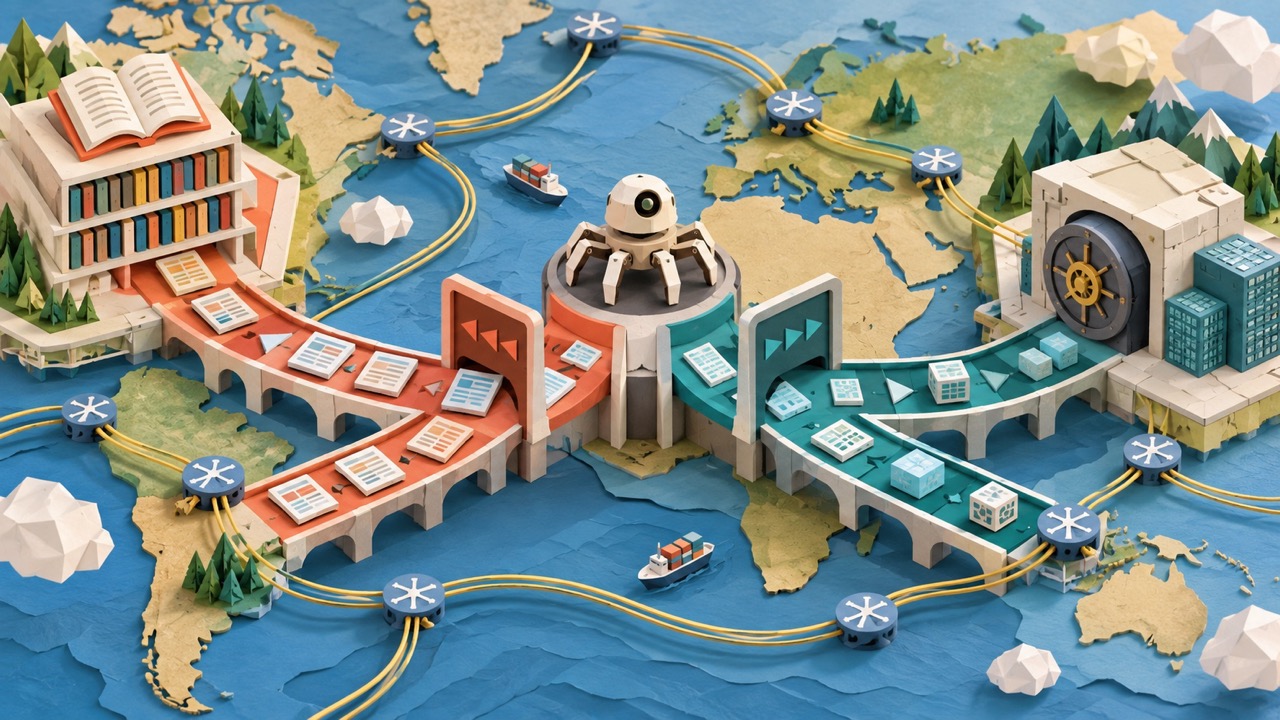
Cloudflare 当前将自动化流量分为三个主要行为:
- 搜索:建立索引,并可能把发现流量带回发布者页面;
- 训练:为模型训练或微调收集材料;
- 代理:根据具体用户指令实时访问页面。
Cloudflare 表示,通用的“阻止”设置现在会作用于同时承担搜索功能的混合用途爬虫,因此可能影响搜索可见性。如果发布者希望保留搜索抓取但拒绝训练使用,应选择更精确的“禁止 AI 训练”。
该公司还提出“Accountable”责任标识,用于识别提供或承诺提供发布者控制、透明报告以及搜索与训练影响分离机制的运营方。Cloudflare 将 Apple、Google 与 Microsoft 列为符合该框架的混合用途爬虫运营方,但各家的实现细节和时间表并不完全相同。
代理团队为什么需要调整
仅按域名、User-Agent 或出口 IP 对采集任务分类已经不够。同一个爬虫身份可能承担多种用途,同一个 URL 也可能允许搜索发现、拒绝训练并限制实时代理访问。
请求进入代理池前,应附加明确的内部用途标签,例如搜索测量、授权研究、广告验证、用户指令访问或模型训练。不同用途应使用独立队列并分别记录。如果一个任务同时存在多个用途,在确认合规路径前,应采用最严格的适用规则。
可结合代理与目标端限流诊断,判断失败来自网络路线,还是来自目标站点有意执行的策略。
同时审计 robots 与实际执行
robots 文件表达偏好,边缘规则负责实际执行。两者应作为相关证据共同保存,而不能互相替代。审计记录至少应包含:
- 对当前 User-Agent 返回的 robots 规则;
- 页面级指令和发布者条款;
- 边缘响应、挑战页或阻止结果;
- 任务声明的真实用途;
- 使用直连、数据中心代理还是住宅代理;
- 观察时间、区域与策略版本。
训练请求被拒绝后,不应通过更换住宅 IP 重试。那只改变来源地址,可能把清晰的拒绝变成规避行为。正确做法是暂停任务、保留证据,并取得授权或改用发布者支持的数据路径。
让搜索测量可复现
搜索可用性测量应使用独立实验组,不与训练或批量采集任务共享 Cookie、会话标识或重试队列。User-Agent、请求头、地点和时序应保持足够稳定,便于比较。平台控制发生变化后,先运行少量合成测试,再恢复生产流量。
对于 IPv4 与 IPv6 混合路线,可参考全球 IPv6 就绪工作流,避免把地址族切换误判为策略变化。
运营检查清单
- 每个自动化任务都有唯一且记录完整的主要用途;
- 混合用途任务采用最严格的适用规则;
- 搜索、训练和代理流量使用独立队列与凭据;
- robots、页面元数据和边缘响应共同归档;
- 代理轮换不会重试明确的策略拒绝;
- 必须走代理时已禁用直连回退;
- 速率、并发和重试预算保持保守;
- 策略测试仅使用授权目标与合成数据;
- Global、北美、欧洲与 APAC 结果分别报告;
- 策略变化在恢复生产前经过复核。
常见问题
“禁止 AI 训练”会阻止搜索抓取吗?
Cloudflare 将其定位为保留搜索发现、同时表达禁止训练偏好的选项。独立的“阻止”选项可能完全停止混合用途爬虫,并影响搜索可见性。
住宅代理能让训练爬虫变成搜索爬虫吗?
不能。网络来源与任务用途是两件事,代理不会改变意图、身份义务或授权状态。
请求被阻止后是否应更换 IP 重试?
不应。明确拒绝应立即停止任务,先检查配置与授权,再使用发布者支持的方式访问。
更新后应该测量哪些指标?
按用途、User-Agent、区域、地址族和策略版本统计允许、拒绝、挑战与模糊结果,关注合规且有效的结果,而不是原始请求量。
合规说明
仅对获授权的服务与数据执行爬虫和代理测试。遵守 robots 控制、合同条款、速率限制、隐私义务与地区法律。不得通过轮换地址、修改请求头或浏览器自动化规避明确限制。
内部来源记录:Cloudflare《Have it both ways: stay discoverable in search while disallowing AI training》,2026 年 9 月 15 日。